
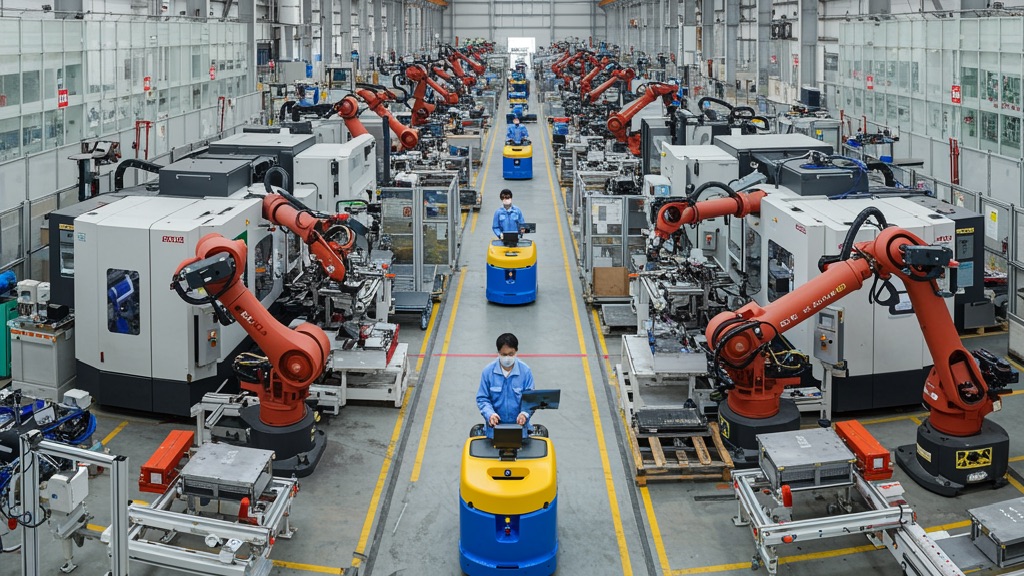
제조 AI는 범용 챗봇을 공장에 들여놓는 일이 아니라 현장 데이터와 장비, 작업 절차에 모델을 맞추는 과정이다. 제조 현장에서는 멋진 데모보다 불량률 0.1%를 줄이는 일이 중요하다. 공개 가중치 모델은 공장 데이터가 외부로 나가기 어려운 환경에서 직접 설치하고 바꿔 쓸 수 있다는 장점이 있다. 하지만 모델을 내려받는 것과 현장에서 돈을 버는 것은 전혀 다른 문제다.

제조 AI는 시범사업에서 보급률 경쟁으로 넘어갔다
2026년 7월 중국 공업정보화부는 규모 이상 제조기업의 AI 기술 보급률이 30%를 넘었다고 밝혔다. 같은 시기 상하이는 산업 특화 모델, 물리 AI, 산업 에이전트와 AI 원생 산업 소프트웨어에 대한 지원책을 내놨다. 제조 AI가 소수 선도 공장의 실험에서 공급망과 지역 산업정책의 문제로 넓어진 셈이다.
다만 보급률이 곧 성과를 뜻하지는 않는다. 단순 기능 사용도 보급에 포함될 수 있고, 기업마다 집계 기준도 다르다. 투자나 도입을 판단할 때는 적용 기업 수보다 불량률, 설비 정지시간, 에너지 사용량과 회수 기간이 얼마나 개선됐는지 다시 확인해야 한다.
모델 파일을 연 뒤부터 진짜 차이가 생긴다. 흔히 오픈웨이트라고 부르는 방식은 학습을 마친 모델 파일을 개발자가 내려받아 직접 비교하게 한다. 개발자와 스타트업, 산업 고객은 외부 AI 도구만 기다리지 않아도 된다. 계속 운영할 때 들어가는 비용과 책임을 계산하고, 특정 업무에 맞게 조정하고, 보안 요구가 높은 환경에서는 내부 운영까지 선택지에 넣는다. 큐원, 딥시크, 지엘엠, 키미 같은 열린 모델은 중국 AI 확산의 주요 방식이다.
열린 모델과 제조 AI는 멀리 떨어져 보이지만 맞닿아 있다. 열린 모델은 작은 회사가 직접 비교할 여지를 넓히고, 제조 현장은 그 시도가 성과로 이어지는지 숫자로 보게 한다. 하나는 도구를 손에 넣기 쉬워졌다는 이야기이고, 다른 하나는 그 도구가 품질과 납기, 손실을 바꾸는 현장이다.
열린 모델은 작은 팀의 선택지를 넓힌다
열린 모델을 만능 열쇠로 보면 위험하다. 오픈소스와도 다르다. 코드와 데이터, 학습 방법과 라이선스가 충분히 열리지 않은 경우도 있다. 상업적 사용 범위, 재배포 범위, 계보, 금지 용도, 책임 제한은 따로 읽어 둔다. 모델 카드와 라이선스를 읽지 않고 “공개 모델”이라는 이름만 믿고 도입하면 나중에 더 큰 문제를 만난다.
작은 회사는 협상 카드부터 갖는다. 해외 AI 도구 하나에만 의존하면 계속 운영할 때의 비용과 관리, 정책 변경 앞에서 선택지가 좁아진다. 이런 모델을 실험해 둔 회사는 일부 업무를 내부 운영형으로 돌리거나, 고객별 보안 조건에 맞게 운영 방식을 바꾼다. 자체 시스템을 운영하지 않더라도 대안이 있다는 사실만으로 협상력이 달라진다.
제품 차별화는 고객의 일에서 출발한다. 열린 모델을 그대로 붙인 기능은 오래 버티지 못한다. 진짜 차별화는 모델보다 고객의 일을 얼마나 깊게 이해하느냐에서 갈린다. 회계 SaaS라면 영수증과 세금계산서, 계정과목과 내부 결재 과정을 챙긴다. 제조 SaaS라면 설비 로그와 품질 리포트, 작업 지시서와 불량 유형을 이해한다. 법무 SaaS라면 조항 비교, 수정 이력, 책임 절차가 제품 설계에 반영된다.
운영 방식도 새로 짠다. 요청마다 가장 무거운 모델을 보낼 이유는 없다. 간단한 분류와 요약, 초안 작성은 작은 AI나 오픈웨이트 기반 시스템이 처리하고, 복잡한 결정이나 고객 영향이 큰 업무만 강한 모델에 맡긴다. 요청을 나누어 쓰면 AI 기능은 프리미엄 장식이 아니라 제품 안에서 관리되는 기능으로 자리 잡는다.
정확도보다 생산 지표를 본다
내려받은 뒤에는 역량 차이가 나타난다. 파일을 받아 비교하는 일과 안정적으로 운영하는 일은 다르다. 실행 서버, 보안 패치, 성능 측정, 입력 문장 관리, 장애 대응, 로그 처리, 개인정보 처리, 업데이트를 챙긴다. 작은 회사가 이 일을 혼자 떠안을 이유는 없지만, 무엇을 직접 하고 무엇을 클라우드나 파트너에게 맡길지는 선명하게 갈린다.
열린 모델은 작은 회사에 “우리도 모델을 가진다”는 꿈보다 “우리 일에 맞는 AI 제품을 직접 시험한다”는 기회를 준다. 이 기회를 살리려면 이름보다 고객이 반복해서 겪는 문제, 데이터 형태, 책임 절차, 돈을 내는 이유를 앞에 놓는다. 방어력은 소유에서만 생기지 않는다. 고객 일을 깊이 이해하고 안정적으로 운영하는 능력이 회사를 지킨다.
선택은 업무의 성격을 따른다. 고객 데이터가 민감하고 지연 시간이 짧아야 하며 반복 호출이 많다면 내부 운영이나 전용 환경 쪽으로 기운다. 반대로 사용 범위가 좁고 기능 변화가 빠르며 최고 성능이 우선이면 외부 AI 도구를 쓰는 편이 편하다. 중간 영역에서는 두 방식을 섞는다. 초안 작성과 분류는 작은 AI가 처리하고, 최종 결정이나 난도 높은 과제만 강한 모델에 맡긴다.
작은 회사는 모델 실험이 제품 기획을 대신하는 상황을 특히 경계한다. 열린 모델을 여러 차례 테스트해도 고객의 일이 바뀌지 않으면 경쟁력으로 이어지지 않는다. 모델 파일은 실험의 폭을 넓히고, 사업은 그 실험을 반복 작업과 지불 구조로 묶는다. 기술이 바뀌어도 남는 고객 문제가 회사의 자산을 만든다.
바꿔 쓸 수 있을 때 힘이 생긴다
열린 모델을 쓰는 힘은 소유보다 교체 가능성에서 나온다. 특정 모델이 느려지거나 이용 환경이 불리해지거나 정책상 쓰기 어려워졌을 때 다른 선택지로 옮길 수 있게 준비한다. 데이터 전처리, 입력 문장, 평가셋, 로그, 평가 기록을 제품에 남겨 두면 기술이 바뀌어도 업무 품질을 비교할 수 있다.
작은 회사가 힘을 얻는 바탕은 고객 업무 샘플, 평가셋, 선택 규칙, 라이선스 기록이다. 문서와 문의, 코드, 이미지, 로그를 민감정보 없이 평가하는 형태로 만들면 비교할 잣대가 생긴다. 기술을 바꿀 때 같은 과제를 풀려 보고 품질과 처리 소요를 비교하는 평가셋도 힘을 발휘한다.
난도가 낮은 업무와 높은 업무, 내부용과 외부용을 나누어 배치하는 규칙이 있으면 사용 범위와 품질을 조절한다. 어떤 모델을 어떤 사용 범위에서 썼는지 남기는 라이선스 기록은 외부 감사와 기업 고객의 보안 절차를 통과할 때 힘을 발휘한다.
중국의 열린 모델 확산은 작은 회사에 기회를 주지만, 기본 기능을 빠르게 흔하게 만든다. 누구나 쓸 수 있는 기술로 만든 요약, 번역, 초안 기능은 차별화가 금세 옅어진다. 작은 회사는 여러 모델을 빨리 실험하되, 고객 데이터의 형태와 업무 절차, 산업별 평가 기록을 자기 제품에 쌓는다. 기술은 바뀌어도 고객의 일은 계속된다.
공장 안에서는 중단 비용이 더 중요하다
기업 고객은 작은 회사에 더 까다롭게 묻는다. 고객사는 “어떤 모델을 쓰는가”보다 “우리 데이터가 어디로 가는가”, “장애가 나면 어떻게 복구되는가”, “감사 로그가 남는가”, “기술을 바꿔도 결과 품질을 설명하는가”를 알고 싶어 한다. 이 선택지는 질문에 답할 폭을 넓혀 주지만, 답을 대신 만들어 주지는 않는다.
제품 문서는 기술 소개보다 운영 설명에 가까워진다. 어떤 모델을 쓰고, 어떤 방식으로 돌리며, 데이터와 로그를 어떻게 보관하는지 밝힌다. 라이선스, 업데이트 주기, 고객별 격리 여부, 대체 계획도 짧게 정리한다. 이 문서가 있으면 영업과 보안 절차에 드는 시간이 줄어든다. 열린 모델을 잘 쓰는 회사는 무엇을 어떻게 쓰는지 숨기지 않고, 사용 경계를 명확히 밝힌다.
스타트업 바깥의 일반 기업도 비슷한 변화를 겪는다. 처음에는 직원들이 공개 챗봇이나 사내 AI 도구로 검색, 요약, 번역, 초안 작성 같은 개인 생산성 업무를 처리한다. 곧이어 부서 단위의 일이 새로 짜인다. 고객센터는 상담 이력을 요약하고 다음 답변을 추천받으며, 구매팀은 계약서와 견적서를 비교한다. 인사팀은 채용 서류와 교육 자료를 만들고, 재무팀은 지출 항목을 분류한다. 법무팀은 조항 차이를 찾으며, 영업팀은 고객 접촉 기록을 바탕으로 제안서 초안을 만든다.
성과는 사내 지식과 업무 시스템이 맞물릴 때 쌓인다. AI가 회사 문서함, 고객관리 시스템, 결재 시스템, 프로젝트 관리 도구, 데이터베이스를 읽지 못하면 답변은 일반론에 머문다. 반대로 권한을 과하게 열어 주면 보안과 책임 문제가 불어난다.
현장 데이터와 장비 연결이 먼저다
기업 AI는 모델 도입보다 권한 설계와 기록 관리에서 성패가 갈린다. 어떤 자료를 읽고, 어떤 결과를 자동 저장하며, 어디부터 사람이 직접 봐야 하는지가 제품 설계에 들어간다.
중국 기업의 AI 사용도 발표 문장보다 업무 안의 변화에서 더 잘 보인다. AI 기능을 앱에 넣었다는 소식보다, 그 기능이 업무 시스템 안에서 어떤 단계를 줄이는지가 더 잘 남는다. 판매자는 상품 등록과 광고 소재 제작 시간을 줄이고, 운영자는 콘텐츠 확인과 추천 품질을 조정한다.
제조 기업은 설비 기록과 작업 지시서를 더 빨리 찾는다. 일반 기업의 AI 도입은 거대한 혁신 선언보다 작은 업무 단계를 줄이며 퍼진다. 그 작은 단축이 반복되면 조직의 속도와 운영 방식도 새로 짜인다.
공장 안에서도 열린 모델은 현실적인 선택지로 떠오른다. 공장 데이터를 외부 AI 도구로 보내기 어려운 기업은 오픈웨이트를 내부망이나 전용 클라우드에서 시험하고 싶어 한다. 직접 운영하려면 서버 환경과 보안, 성능 측정 역량이 받쳐 줘야 선택지가 열린다.
특정 공정 문서, 설비 로그, 품질 리포트, 작업 지시서를 내부에서 처리하면 제조 AI가 맡을 일이 많아진다. 작은 회사가 제조 고객을 상대할 때도 이 요구를 이해할수록 대응 범위가 넓어진다. 모델 성능보다 데이터가 어디서 처리되는지가 구매 결정을 좌우한다.
제조 고객의 품질과 설비, 납기, 문서 검색 문제를 좁게 풀어내는 팀은 대형 AI 기업과 다른 자리를 얻는다. 모델을 만드는 회사가 아니라 현장의 손실을 줄여 준 파트너로 남기 때문이다. 그리고 그 차이는 공장에서 가장 냉정하게 드러난다.
제조 현장: AI가 숫자로 증명되는 곳
제조 현장은 AI의 효과가 가장 빨리 숫자로 드러나는 곳 중 하나다. 공장에는 품질, 수율, 납기, 설비 가동률, 불량률, 에너지 사용량처럼 성과 지표가 이미 있다. AI 적용 뒤 수치가 개선됐는지 악화됐는지 바로 비교한다. 제조 AI는 추상적 혁신보다 손실을 줄이는 기술이다.
중국이 제조 AI를 강조하는 배경도 제조 현장의 현실과 맞닿아 있다. 중국은 제조업 토대가 넓고, 스마트 공장과 산업 인터넷, 로봇, 비전 검사, 물류 자동화를 오래 밀어 왔다.
공업정보화부가 밝힌 수치도 단계별이다. 기초급 스마트 공장 3만 개 이상, 고급급 1,200개, 우수급 230개를 거쳐 이후 스마트 공장은 4만 개를 넘었다. 우수급 공장은 스마트 창고, AI 품질 검사, 디지털 연구개발 등 고도 시나리오를 수행한 사례로 다뤄졌다.
이 수치를 중국 제조업의 평균 성숙도라고 보면 곤란하다. 당국 발표 수치는 정책 기조와 실험장의 폭을 가리키는 신호이지, 개별 공장의 AI 사용 수준을 보증하지 않는다.
제조 현장에서 자주 드러나는 업무는 불량 감지, 예지보전, 생산 계획, 작업 지식 검색이다. 이미지와 센서 데이터는 결함을 찾고 사람이 놓치기 쉬운 패턴을 잡는다. 설비 로그와 고장 이력은 멈춤을 줄이는 예지보전의 재료로 쓰인다. 생산 계획은 납기와 수요, 자재와 인력, 설비 상태를 한눈에 놓을 때 의미가 분명해진다. 매뉴얼과 품질 리포트, 정비 기록과 고객 클레임은 작업자가 즉시 찾는 지식 묶음으로 정리된다.
제조 현장의 AI 업무에서는 멋진 시연보다 기준선부터 잡는다. 기존 불량률은 얼마였는가. 검사 시간은 얼마나 걸렸는가. 설비 정지는 월 몇 시간인가. 작업자가 자료를 찾는 데 쓰는 시간은 얼마인가. AI 적용 뒤의 성과도 이 수치들이 얼마나 달라졌는지로 평가된다. 기준선이 없으면 AI 프로젝트는 홍보 자료에 머문다.
맞춤 구축 뒤에도 유지비가 남는다
한국 제조업도 이 흐름을 남의 일로 볼 수 없다. 반도체와 배터리, 자동차와 조선, 철강과 디스플레이, 화학처럼 데이터가 쌓이고 품질 책임이 무거운 산업을 갖고 있기 때문이다. 다만 데이터가 많다고 곧바로 AI 성과가 생기지는 않는다. 라벨링, 설비별 데이터 형식, 현장에서 쓰는 말, 보안, 협력사 사용 권한, 작업자 수용성이 함께 맞아야 한다.
제조 AI는 대개 한 공정, 한 라인, 한 품질 이슈에서 출발한다. 전 공장을 한 번에 바꾸는 장면보다 불량 손실이 크고 데이터가 확보된 지점을 좁혀 보는 편이 더 설득력 있다. 현장 작업자, 품질팀, 설비팀, IT팀이 같은 기준선을 보고 AI 결과와 기존 작업 결과를 비교할 때 현장 확인은 성과로 넘어간다.
한국 제조 기업이 받는 압력은 크게 두 가지로 나타난다. 먼저 AI를 적용할 문제의 폭이 넓어진다. 한 번 처리하는 데 드는 비용이 줄어들면 제조 현장의 작은 문제에도 AI를 적용하는 실험이 늘어난다. 동시에 데이터 결합 속도도 빨라진다. 중국 기업이 생산, 물류, 품질, 판매 데이터를 더 촘촘하게 엮으면 경쟁의 잣대도 새로 세워진다.
제조 현장에서 AI는 사람을 대체한다는 구호보다 낭비를 줄이는 데 많이 쓰인다. 불량을 줄이고, 설비 멈춤을 줄이고, 작업자의 검색 시간을 줄이고, 납기 예측의 오차를 줄인다. 숫자로 증명되는 곳에서 AI는 유행어를 넘어 운영 개선으로 이어진다.
현장에서는 적용 범위보다 비교 기록부터 남긴다. 비전 검사를 예로 들면 기존 검사원의 판정, AI 판정, 최종 품질 판정을 일정 기간 같은 방식으로 기록한다. 예지보전도 마찬가지다. 경고가 고장 감소로 이어졌는지, 불필요한 정비를 늘리지는 않았는지가 기록으로 이어져야 한다. 제조 AI는 거창한 구호보다 이런 비교 기록 위에서 신뢰를 쌓는다.
현장 작업자의 신뢰도 그냥 생기지 않는다. AI가 현장의 말과 일하는 절차를 이해하지 못하면 강한 모델도 외부 컨설팅 결과물에 머문다. 작업자가 왜 알림이 떴는지, 어떤 조치가 필요한지, 틀렸을 때 어떻게 정정하는지 이해할 때 신뢰가 생긴다. 제조 AI는 모델 정확도와 현장 작업자의 수용도가 함께 올라갈 때 성공에 가까워진다. 어느 한쪽이 약하면 결과도 크게 흔들린다.
도입 전 보안과 책임선을 정한다
협력사와 공급망도 분리되지 않는다. 제조 자료는 한 회사 안에만 있지 않다. 원재료, 부품, 물류, 품질 클레임, 납기 변경 정보가 여러 회사에 흩어져 있다. AI가 생산성을 바꾸려면 자료 공유 범위, 접근 권한, 사고가 났을 때의 몫이 계약에 담긴다. 제조 AI는 공장 안의 기술이면서 공급망의 약속을 새로 세우는 일이다.
중국 제조 AI를 자세히 보는 까닭은 규모에만 있지 않다. 중국은 제조 현장과 산업 인터넷, 로봇과 물류, 전자상거래와 지방정부 프로젝트가 한 시장 안에서 만난다. 중국 정부가 AI와 첨단 제조를 깊게 결합하겠다고 반복해서 강조하는 정책 기조도 이 배경과 맞닿아 있다. 스마트 공장 숫자가 평균적인 고도화를 보장하지는 않지만, 실험할 현장은 충분하다. 특정 공정에서 확인된 비전 검사, 예지보전, 생산계획 최적화가 다른 공장과 산업으로 복제되는 환경이 만들어진다.
한국 제조 기업은 제조 AI의 확산을 경쟁 요인으로만 볼 필요가 없다. 고품질 제조와 글로벌 고객 대응, 반도체와 배터리, 자동차와 조선 등 복잡한 산업 경험은 여전히 강점이다. 여기에 AI를 더하면 단순 자동화를 넘어 품질 신뢰와 납기 안정성, 에너지 효율, 협력사 관리까지 강해진다. 제조 AI는 멋진 대시보드보다 고객이 체감하는 납기와 품질을 겨냥한다.
제조 AI는 처음엔 돕고, 다음엔 예측하고, 마지막엔 조정한다. 처음에는 작업자가 문서를 찾고, 설비 기록을 요약하고, 불량 이미지를 분류하는 데 AI를 쓴다. 조금 더 나아가면 설비 이상, 수요 변동, 품질 이슈, 납기 지연 징후를 미리 감지한다. 더 성숙한 단계에서는 생산 계획과 재고, 에너지와 설비 배치를 조정한다. 대부분의 기업은 보조와 예측 사이에서 시작하는 편이 안전하다.
중국 제조 AI도 같은 단계로 나눠 볼 수 있다. 스마트 공장이라는 이름만으로는 수준을 알 수 없다. 어떤 공정에 AI가 들어갔는지, 사람이 최종 판정하는지, 불량과 작업 시간이 줄었는지, 다른 공장으로 옮겨 갔는지를 따져 봐야 과장과 개선이 갈린다.
오픈웨이트가 제조 AI를 바꾼 지점도 여기서 분명해진다. 모델을 내려받게 되면서 공장 데이터를 밖으로 보내지 않고도 시험할 길이 열렸다. 열린 것은 문이지 성과가 아니다. 그 문을 지난 뒤에 불량률과 설비 정지시간, 검색 시간이 실제로 줄었는지는 여전히 현장의 숫자가 판정한다.
자주 묻는 질문
오픈웨이트 모델은 작은 팀에 어떤 선택권을 주나?
오픈웨이트는 학습을 마친 모델 파일을 직접 내려받아 비교·조정하고, 보안 요구가 높으면 내부에서 운영까지 할 수 있게 해 준다. 작은 팀에게는 해외 도구 하나에 묶이지 않는 협상력과 대안이 생기는 셈이다. 다만 오픈소스와 달리 코드·데이터·라이선스가 다 열린 것은 아니므로, 상업적 사용 범위와 재배포·책임 조건을 모델 카드에서 반드시 확인해야 한다.
제조 AI의 성과는 어떤 숫자로 확인해야 하나?
제조 AI는 정확도 같은 기술 지표가 아니라 현장에 이미 있는 성과 지표로 판단해야 한다. 불량률, 설비 정지시간, 에너지 사용량, 작업자의 자료 검색 시간, 회수 기간이 적용 전후로 얼마나 달라졌는지를 본다. 기준선을 먼저 잡지 않으면 어떤 프로젝트든 홍보 자료에 머문다.
참고자료
- Alibaba Cloud. (접속: 2026년 5월). Qwen. 원문 보기
- Huawei Cloud. (2025). Pangu Large Models Service Overview. 원문 보기
- McKinsey & Company. (2025). From pilots to performance: How COOs can scale AI in manufacturing. 원문 보기
- The State Council Information Office of China. (2025). China establishes over 30,000 smart factories: ministry. 원문 보기
- 중국정부망/Xinhua. (2026). Chinese premier stresses promoting deep integration of AI, advanced manufacturing. 원문 보기
- World Economic Forum. (2025). Global Lighthouse Network 2025. 원문 보기
- Open Source Initiative. (2024). The Open Source AI Definition 1.0. 원문 보기
- 중국 공업정보화부 등 8개 부처. (2026). 「인공지능+제조」 특별 행동 실시 의견. 원문 보기
- 중국 공업정보화부. (2026). 2026년 상반기 공업·정보화 발전 현황 기자회견. 원문 보기
- 상하이시 경제정보화위원회. (2026). 상하이시 AI+제조 발전 촉진 조치. 원문 보기